返回 Personal AI Collection
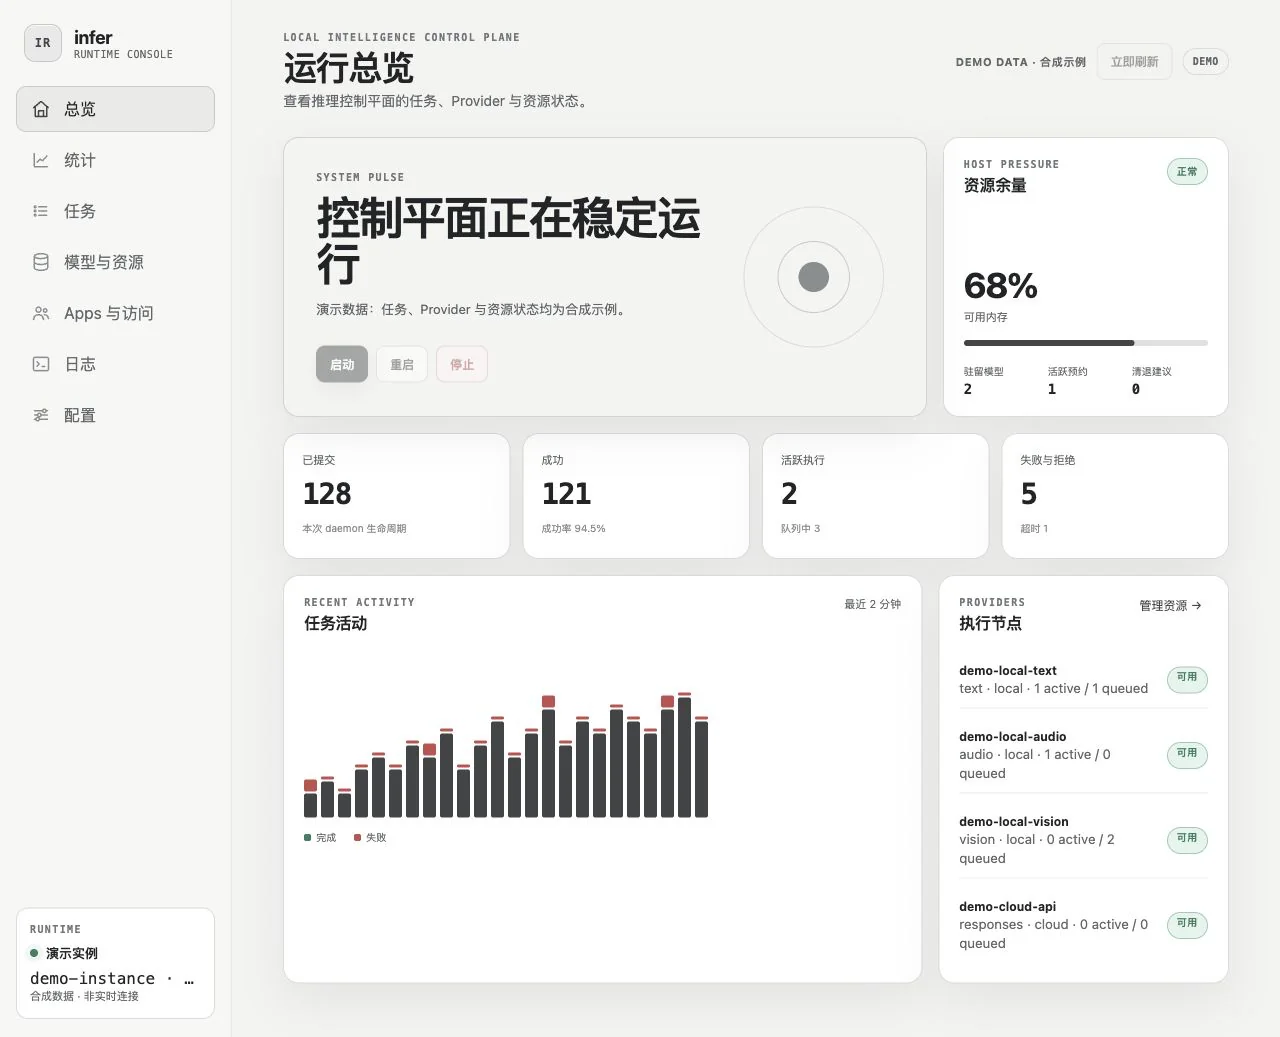
仓库提供的 Console 界面;Provider、Deployment、指标和实例身份均为合成演示数据。 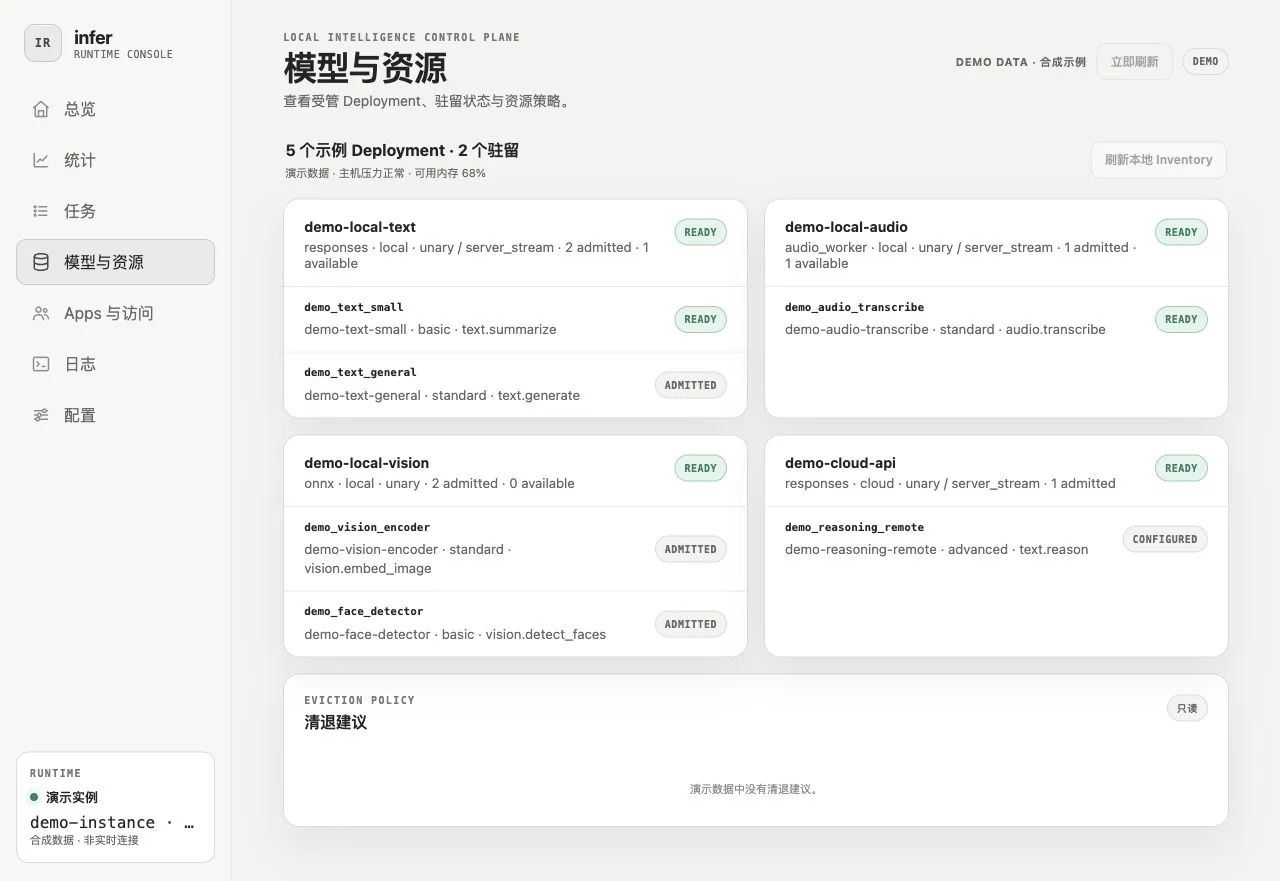
infer-runtime 是一个面向本机应用的 AI 推理运行时。Consumer 提交 Intent、能力下限、延迟、位置、隐私和回退约束;Runtime 选择 Provider 与 Deployment,并处理排队、配额、模型驻留、取消、故障切换和执行记录。
它统一控制平面;文本、音频和视觉继续使用各自的类型化协议。
当前实现
文本支持 Responses 风格的普通请求与 SSE、本地加密 background,以及本地、云端和订阅式 Provider。订阅桥仍为实验功能。
音频包括转写、强制对齐、语音合成、声音生成、声音克隆、事件检测和 audio-text retrieval。流式与部分生成、检索能力仍在实验阶段。
视觉目前提供范围受限的 ONNX/Core ML 能力,包括人脸、图文向量、主体分割和人脸解析;部分模型权重仅限研究用途。
调度与资源实现 Intent 路由、优先队列、deadline、取消、retry/fallback、熔断、配额,以及 Ollama/ONNX 生命周期和资源压力采样。
Consumer 接入
应用通过独立身份和 ACL 使用 Runtime。Intent 与物理模型名分开,Runtime 按约束选择具体的 Provider、Build 与 Deployment;local_only、offline、模态外发权限和 fallback 不会被静默放宽。
本机 Consumer 可以通过 Infra Discovery 查找 infer-runtime.consumer-core 的当前 endpoint,也可以使用 infer-runtime-client 处理发现、generation 变化、token、合同 header 和错误解析。
状态与边界
项目目前是开发预览。核心调度、本地资源、访问控制和 Console 已形成可运行路径;部分音频、视觉和订阅式能力仍为 experimental。自动 eviction 默认关闭,可能产生费用或改变模型驻留状态的 probe 需要 Operator 显式执行。
Provider、Deployment 与模型文件由部署环境分别配置。Runtime 的范围是推理资源接入、选择和调度。