
Knowledge Blind Box
第五章 后训练、对齐与模型适配
Original text in Chinese. This English page translates only the site interface and metadata.
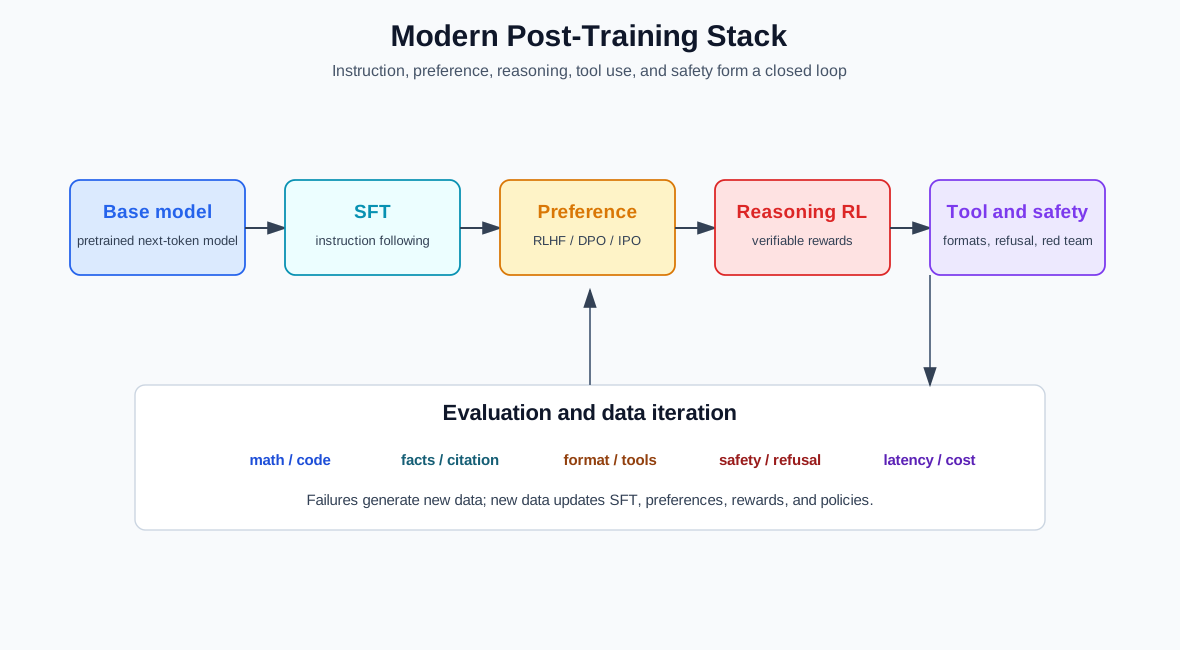
预训练让模型学习训练分布中的条件规律,却不直接规定它怎样响应指令、何时拒答、怎样调用工具,或怎样在多个可接受回答中取舍。后训练使用规模较小但目标更明确的数据和反馈,改变模型在给定接口下的行为。
“对齐”不是单一损失,也不是已经完成的性质。必须说明模型要对齐谁的偏好、在什么任务和权限边界内、以什么证据评价。本章先给出训练目标,再讨论数据与系统边界。
5.1 方法地图:数据从哪里来,梯度怎样产生
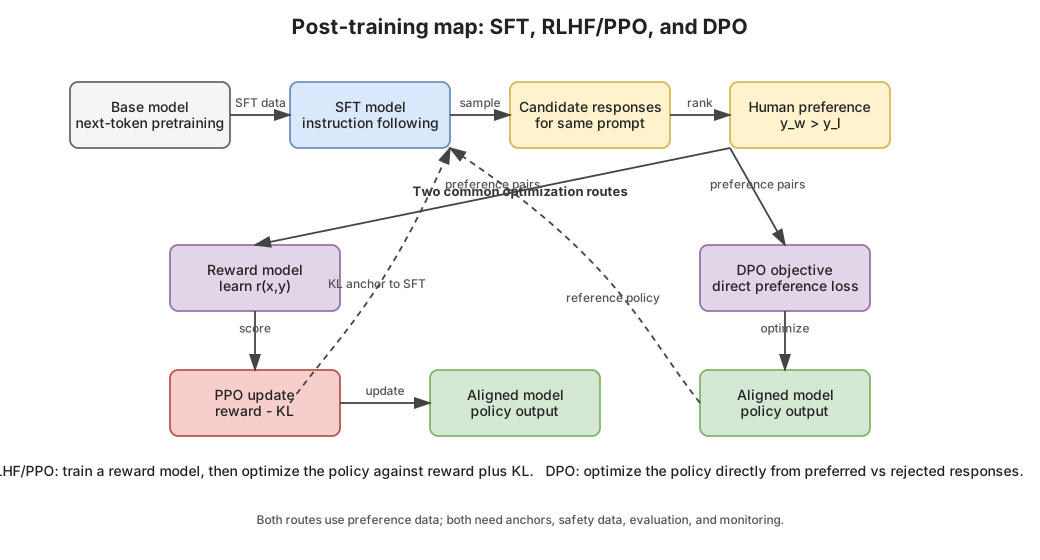
后训练方法可以按监督信号与采样方式区分:
| 方法 | 训练记录 | 直接优化的量 | 是否需要当前策略在线采样 |
|---|---|---|---|
| SFT | 参考回答的 token likelihood | 否 | |
| reward model | 偏好比较 likelihood | 否 | |
| PPO-RLHF | prompt、策略轨迹、reward | 估计的期望正则化奖励 | 是 |
| DPO | 与参考策略 | 胜负回答的隐式 reward 差 | 否 |
| 可验证 RL / GRPO 类方法 | prompt、多条策略轨迹、验证 reward | 组内相对优势下的策略目标 | 通常是 |
| 蒸馏 | 教师分布、回答或轨迹 | 教师行为的拟合损失 | 视数据生成而定 |
“在线”是指训练过程中用正在更新或其近邻版本的策略生成新轨迹,不等于互联网在线服务。离线偏好优化可以更简单、可复现,却受固定候选分布限制;在线方法能探索新输出,也更容易进入 reward 或验证器未覆盖的区域。
5.2 Supervised Fine-Tuning
5.2.1 对话序列化与 loss mask
设一条多轮记录经 chat template 序列化为
其中包括 system、user、assistant、工具结果、角色边界和停止 token。定义 表示位置 的目标 token 参与训练,并假设 ,则
常见做法只令 assistant 回答区域的 ,但也可以训练工具调用、system 模板或用户 token。选择会改变模型学到的条件分布。attention mask 决定 能读取哪些前缀,loss mask 决定该位置是否被监督,二者仍不可混用。
若 batch 内先对每条样本求平均再对样本平均,短回答与长回答权重相同;若先汇总全部有效 token 再归一化,每个 token 权重相同。两种目标都合理,但并不等价。数据配方必须声明归一化单位、样本权重和截断方式。
5.2.2 SFT 能教什么
SFT 同时教给模型任务内容、角色边界、格式、语气、停止方式和工具调用语法。高质量答案不只是“最终结论正确”:序列化中的隐藏模板、空白、结束标志和错误处理都会被拟合。
SFT 的支持集仍有限。训练集中从未出现的组合任务,不会因“指令微调”这个名称自动解决;同一答案被大量复制也会提高特定文风和模板的经验权重。
5.3 偏好数据与 Reward Model
5.3.1 偏好不是事实标签
对同一条件 ,偏好记录给出候选 与 ,表示前者按声明的 rubric 更可取。偏好可来自人工比较、规则、模型裁判、可执行测试或它们的组合。
“更受偏好”不等于“更真实”。若候选生成器很弱,比较数据只覆盖一小块输出空间;若标注者奖励自信、长度或固定格式,模型会学习这些代理。数据记录至少应包含候选来源、生成参数、rubric 版本、标注者类型、分歧与弃权。
5.3.2 Bradley-Terry reward model
一种常见假设是偏好概率只由两个标量 reward 的差决定:
对已观察胜负对的负对数似然为
因为损失只含差值,对同一 prompt 加任意常数 ,即令
不会改变偏好概率。故 pairwise 数据不识别跨 prompt 的绝对 reward 零点;把两个不同 prompt 的 raw score 直接比较,需要额外校准假设。
reward model 只在候选与标注分布附近经过验证。策略主动寻找高分输出时,可能进入模型外推区域并利用代理漏洞,这就是 reward hacking 的一个来源。
5.4 KL 正则化的 RLHF 目标
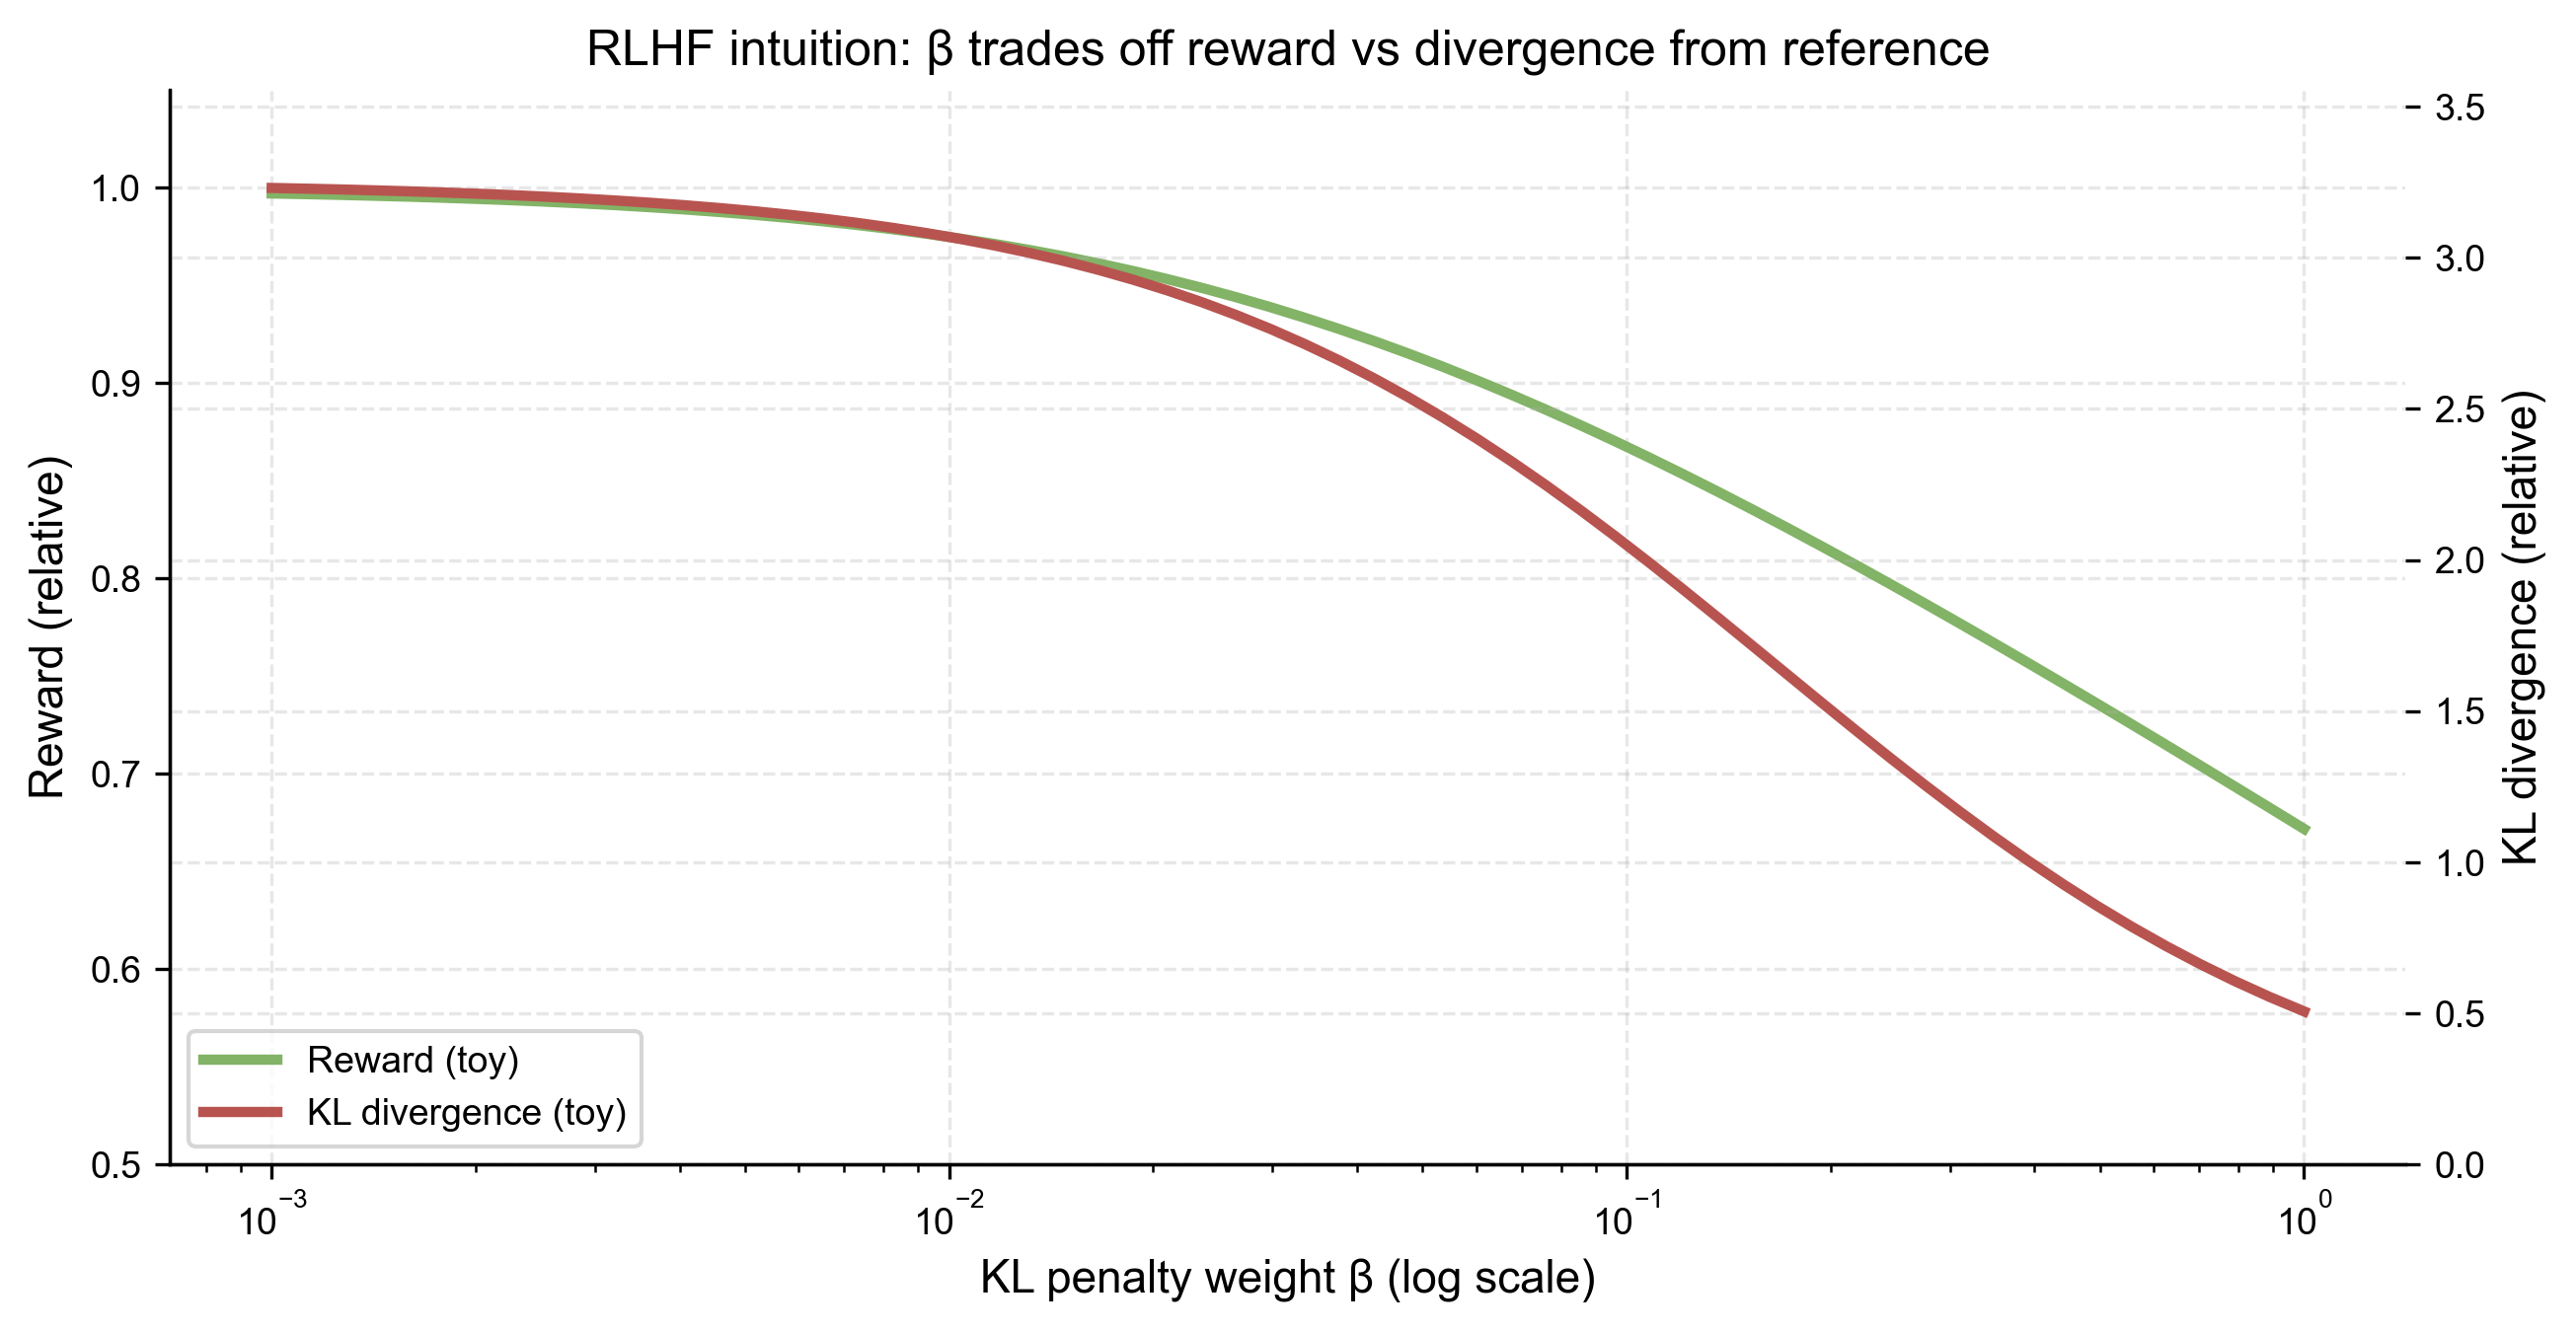
给定 prompt 分布 、参考策略 和 reward ,一种标准的分布级目标是
控制偏离参考策略的代价。对固定 和离散输出空间,加入归一化约束后对 求驻点,可得
该解定义在 的支持集上;若 ,任何给该 正概率的策略都会产生无限 KL。这个闭式解说明 reward 倾向与参考概率共同决定最优分布。 越大,在 reward 尺度固定时策略越受参考分布约束。
采样实现常把完整输出的整形 reward 写为
因为对 取期望会恢复 KL 项。对自回归策略,序列 log-ratio 又等于各 token log-ratio 之和。参考策略 是正则化锚点,不等于稍后用于重要性采样的旧策略 。
5.5 PPO 在语言模型后训练中的位置
把状态写成 ,动作写成下一个 token 。用旧策略 采样轨迹后,定义概率比
PPO 的 clipped surrogate 最大化目标为
由 reward、value critic 与回报估计产生。clip 使会继续放大代理目标的过大概率比停止贡献相同方向的增益,但它不把实际策略硬约束在区间内,也不保证真实性或安全性单调提高。完整训练还包含 value loss、entropy 或 KL 控制、rollout 批次和多轮 epoch。
RLHF 不是 PPO 的同义词。reward 建模、轨迹采样、优势估计、KL 锚定和策略更新是不同模块;PPO 只承担其中的策略优化。逐步推导见强化学习与 PPO 附录,来源见 Schulman et al., 2017 与 Ouyang et al., 2022。
5.6 DPO:从正则化最优策略到分类损失
由上一节的闭式最优策略反解 reward:
把它代入 Bradley-Terry 模型时,同一 prompt 的 在胜负差中抵消。用待训练策略 表示 ,得到
DPO 因而可以直接用偏好对训练策略,不必先拟合显式 reward model,也不需要在这一步在线 rollout 或训练 critic。这个推导依赖 KL 正则化最优策略与 Bradley-Terry 偏好假设;它不是“任意偏好数据上都等价于任意 RLHF 实现”的结论。
序列 log probability 是 token log probability 之和:
长度因此进入目标。把总和改成长度平均可以改变长度偏置,却也改变标准 DPO 所对应的隐式 reward。偏好候选的长度分布、截断与结束 token 必须共同检查。DPO 来源见 Rafailov et al., 2023。
5.7 采样、筛选与在线数据闭环
5.7.1 Best-of- 与 rejection sampling
给定 prompt,从策略独立采样 个候选并选择 reward 最大者:
增加 不会降低所用 reward 的期望最大值,却使最终输出不再服从原策略 ,并近似按 倍增加生成开销。若把获胜回答回灌 SFT,产生的是经过选择器重加权的离线数据;选择器偏差会一起被蒸馏。
5.7.2 在线与离线的分布差异
离线偏好集中的候选来自某个行为策略 。训练后的 若远离 ,数据不再覆盖它常生成的失败。在线循环可以用新策略补充候选,但 reward model、规则和人工审核也必须跟随扩展;仅“重新采样”不能自动修复监督信号的盲区。
5.8 可验证奖励、GRPO 与推理强化
数学、代码和形式任务可以用最终答案、单元测试或证明检查器提供较客观反馈。对同一 prompt ,从旧策略采样 个回答 ,得到 reward 。组内标准化优势可写为
GRPO 类目标用组内相对优势替代单独训练的 value critic。一个代表性 clipped 形式是
其中 是新旧策略 token 概率比, 表示对参考策略的 KL 估计。具体实现对 advantage、KL 估计和 token 归一化有不同变体,引用方法名时应给出公式版本。
减去组均值严格消除 reward 的加性平移。若 且标准差非零,正比例缩放 reward 也不改变 ;实际使用 时,这一尺度不变性只在组标准差远大于 时近似成立。若一组 reward 全同,分子全为零,策略优势信号恰为零。组内标准化可缓和 prompt 间尺度差异,但不保证完全消除它,也不消除 rollout 成本、reward hacking 或 on-policy 分布漂移。
可验证 reward 通常只证明测试通过,不证明推理文本忠实反映内部因果过程。模型可能利用测试缺口、浮点容差、环境状态或答案泄漏。隐藏测试、沙箱、过程检查与对抗样本分别覆盖不同风险。来源见 Shao et al., 2024 与 DeepSeek-AI, 2025。
5.9 拒答与安全后训练
安全训练常包含危险请求、边界案例、良性近邻和替代帮助。只增加拒答样本容易造成过度拒答;只奖励任务完成又可能让模型忽略风险。需要分开评价:
- 明确危险任务的拒绝;
- 良性近邻任务的能力保持;
- 含糊请求的澄清;
- 多轮诱导和上下文污染;
- 工具环境中的实际权限遵守。
模型侧训练只是系统安全的一层。真实工具权限、身份、资源配额和副作用确认仍由第十一章的运行时控制。一个模型说“我不能执行”不等于系统已经撤销其权限。
5.10 后训练数据工程
后训练数据远少于预训练数据,单条样本的模板和质量影响更大。管线应覆盖任务与难度分层、候选生成、去重、人工审核、rubric 版本、污染检查和失败样本回流。
合成数据可以扩大规模,但教师错误、固定文风和同质化也会被复制。合格记录应区分:人工原始样本、模型候选、验证器接受、模型裁判选择和人工修订。仅把最终记录统称“高质量数据”,无法追踪偏差来自何处。
继续预训练与 SFT 也不能互换:
- continued pretraining 延续语言建模目标,主要改变领域语料分布、术语和文体;
- SFT 在序列化任务上提高指定回答的条件 likelihood,直接塑造接口行为;
- 偏好优化或 RL 在多个候选之间施加相对或 reward 信号。
它们可以串联或交错。数据混合、学习率、步数与保留集决定学会新领域和遗忘旧能力之间的取舍。
5.11 蒸馏
设教师与学生在温度 下的 token 分布为 与 。logit 蒸馏的一项常写为
用于补偿 softmax 温度对梯度尺度的影响,实践中还可与真实标签交叉熵混合。若教师只通过 API 暴露文本,蒸馏就退化为对教师采样回答或轨迹做 SFT、筛选或偏好训练,无法获得完整 soft target。
学生获得的是蒸馏数据中可学习的教师行为,不是教师权重或完整内部机制。能力受学生架构、容量、tokenizer、采样分布和选择器限制。
5.12 LoRA、QLoRA 与参数高效适配
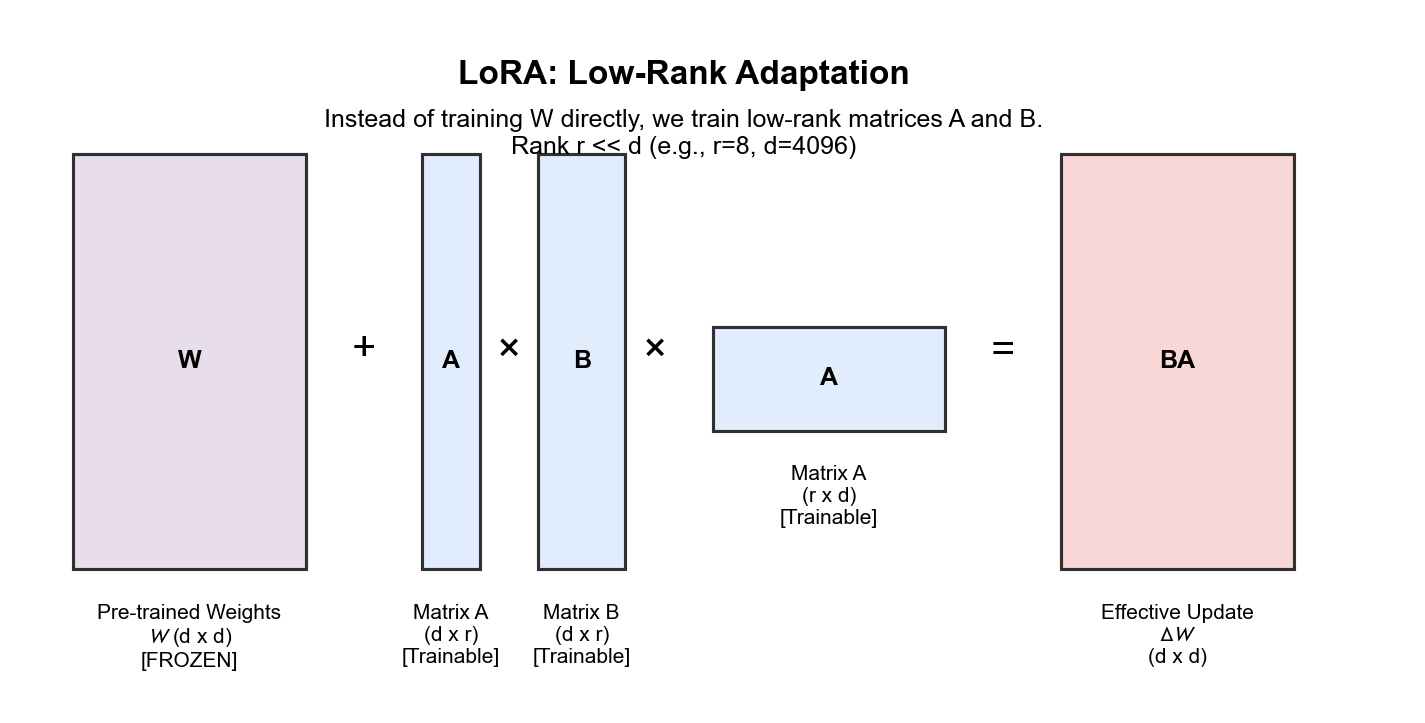
对冻结权重 ,LoRA 把更新限制为
其中
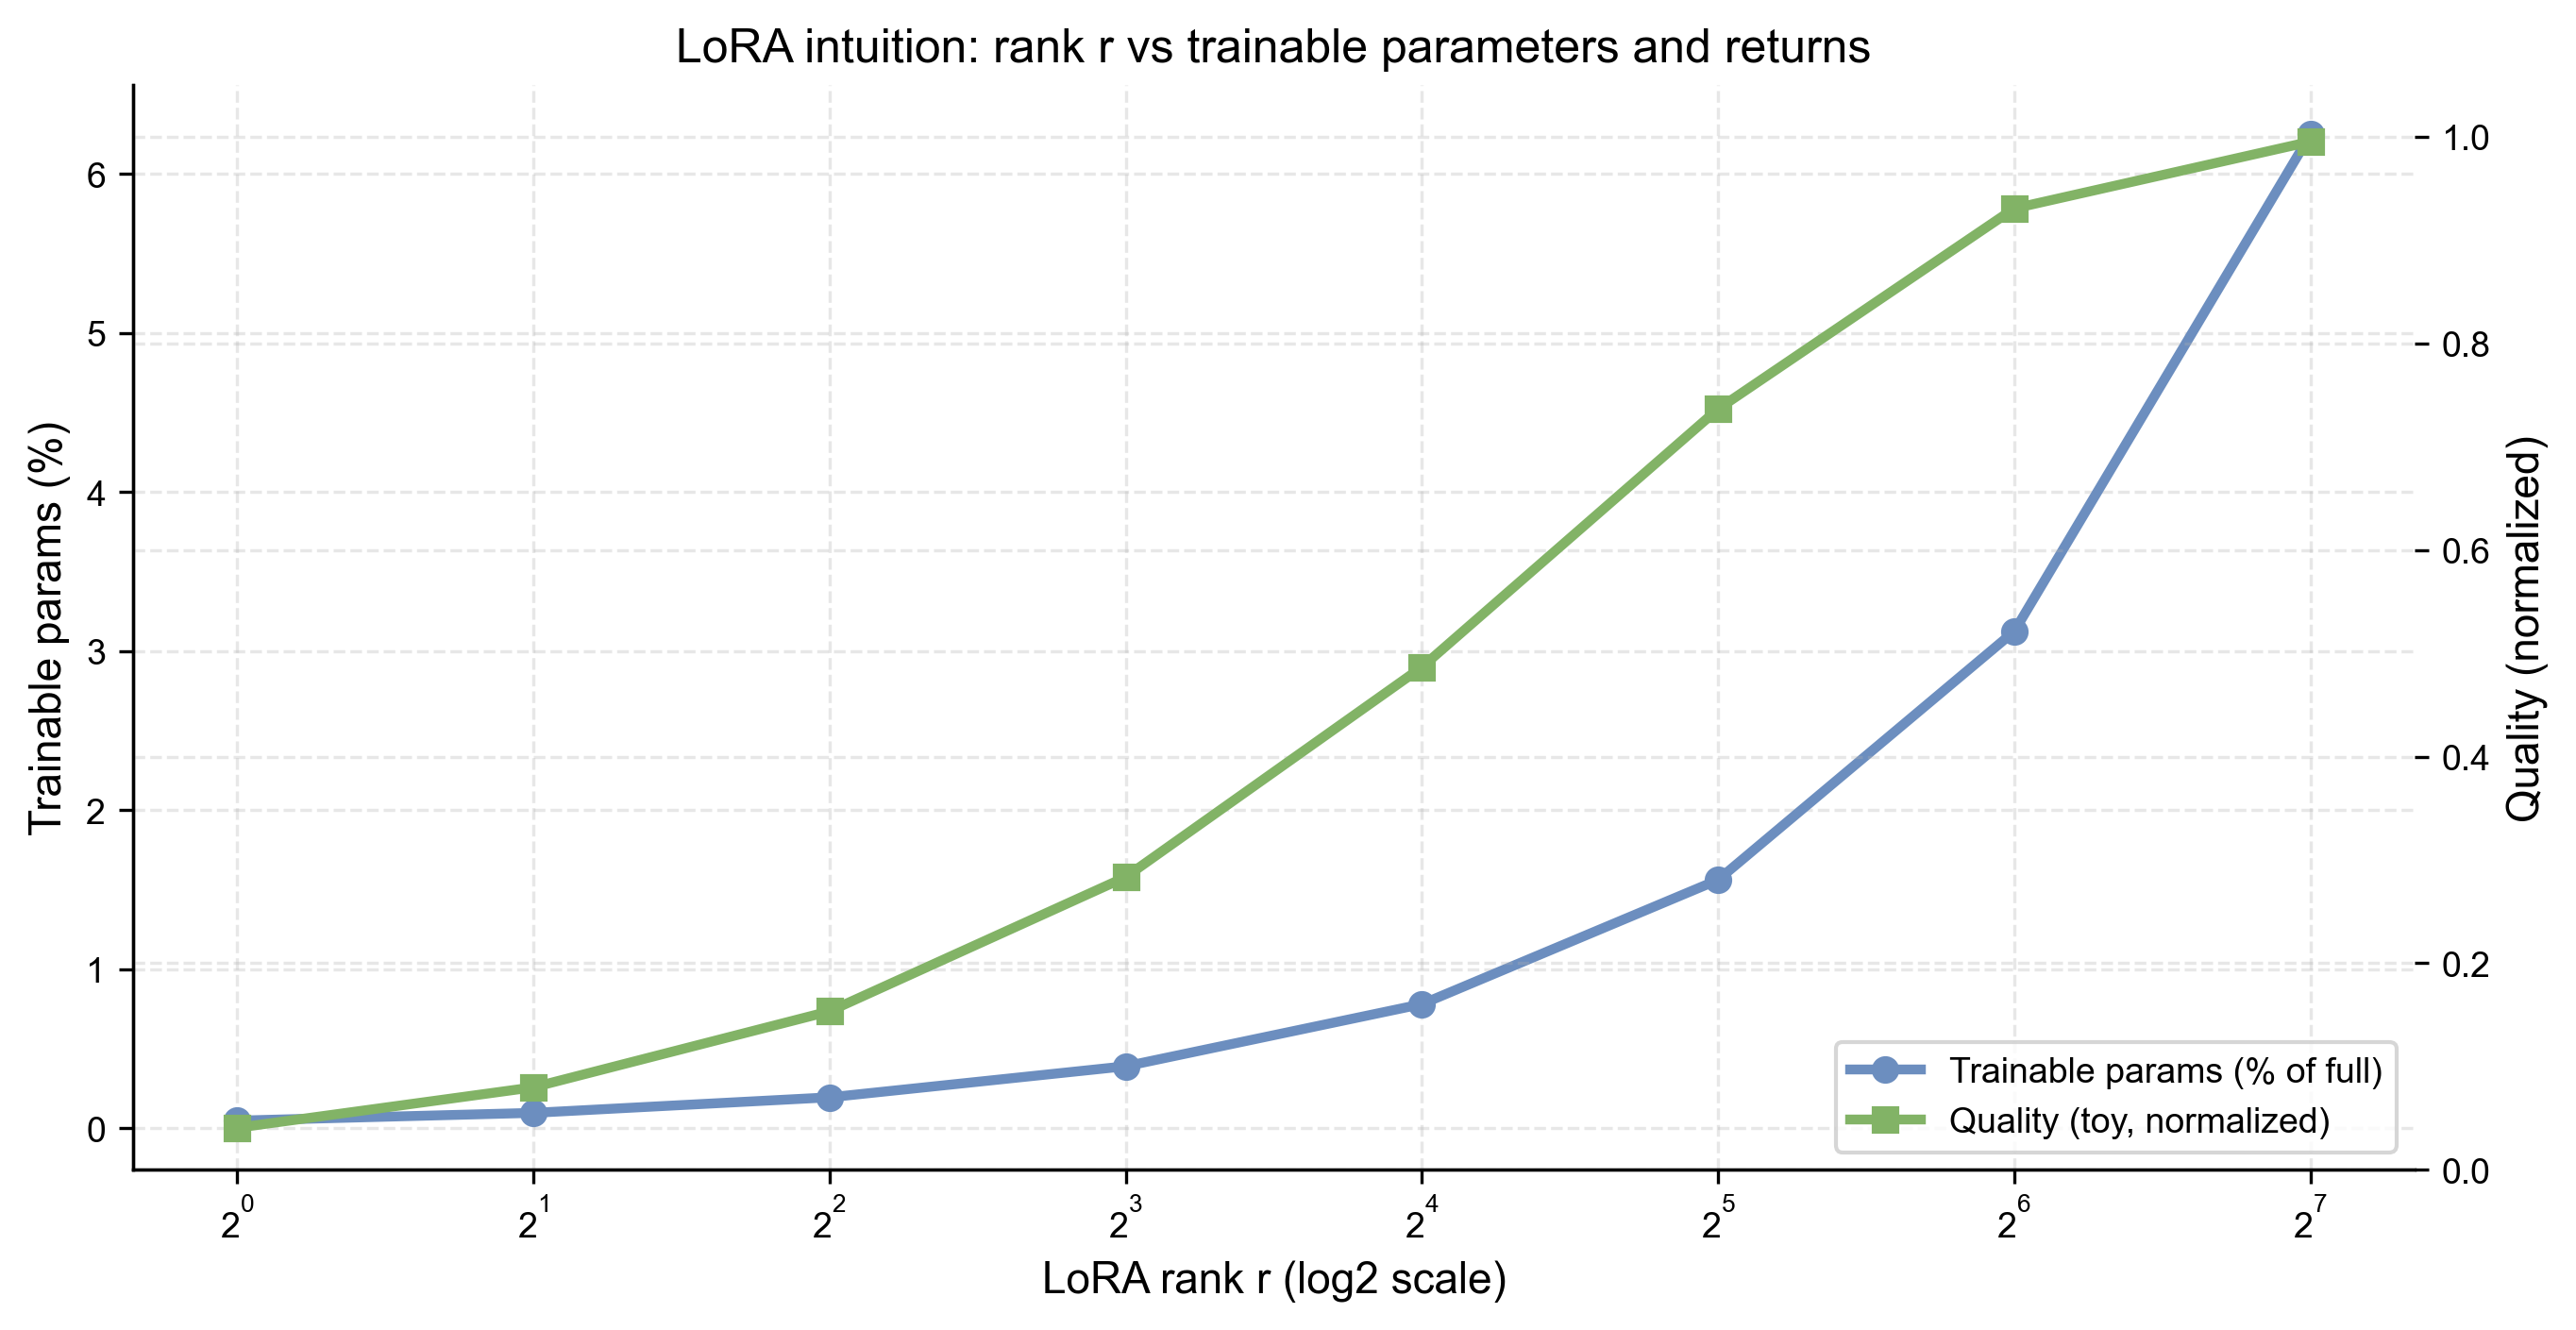
该层训练参数量是
而完整矩阵有 个参数。常把一个因子初始化为零,使训练开始时 ; 控制 adapter 更新尺度。选哪些 query、key、value、output 或 MLP 矩阵作为目标,和秩 同样重要。
QLoRA 冻结量化后的底模权重,在矩阵运算时按 kernel 需要反量化或使用低精度计算,只对 LoRA 参数反向与维护优化器状态。它降低训练显存,不表示底模量化误差消失,也不保证任意 adapter 可无损合并到任意量化工件。
来源见 Hu et al., 2021 与 Dettmers et al., 2023。
5.13 模型合并
若多个微调模型来自同一底模,最简单的 task-vector 组合为
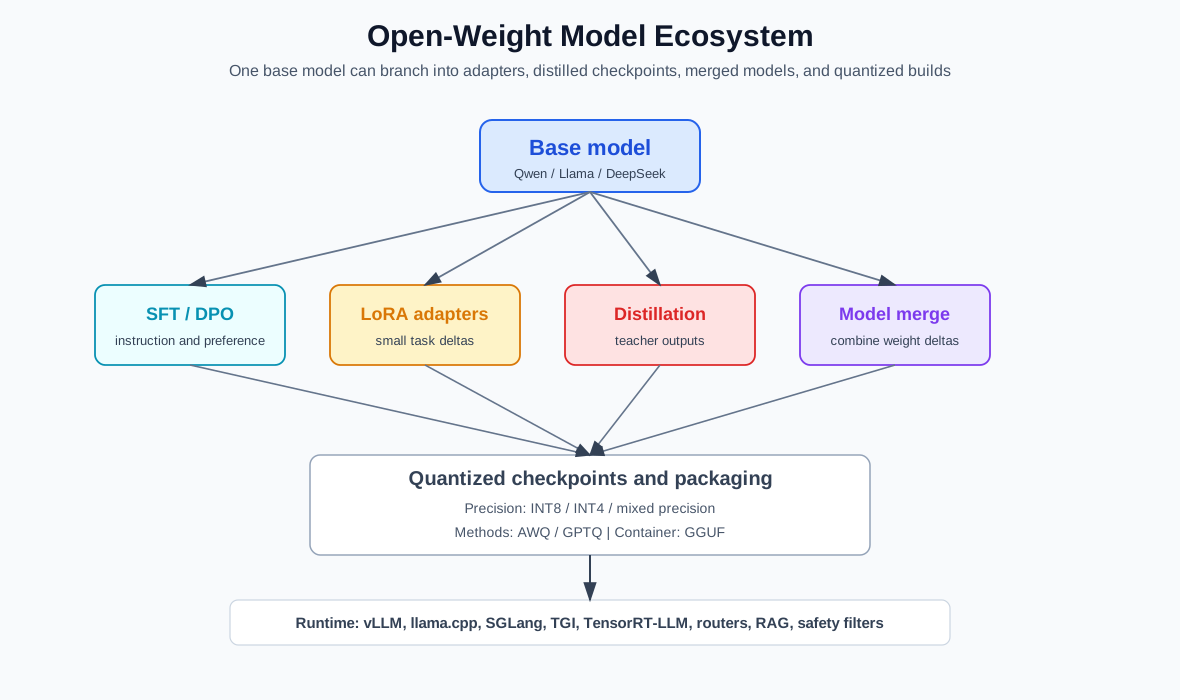
权重形状相同只是可执行条件,不是功能兼容保证。不同微调轨迹可能在同一参数方向上产生冲突;adapter 的秩、缩放和目标模块也可能不同。合并后必须重新评价,不能把各子模型分数直接相加。
5.14 后训练怎样评价
评测首先固定模型工件、chat template、system prompt、解码参数、工具版本和最大长度。否则比较的可能是两套服务配置,而非两种后训练方法。
| 方面 | 例子 |
|---|---|
| 指令跟随 | 格式、约束、多轮一致性 |
| 任务能力 | 知识、代码、数学、领域任务 |
| 偏好 | 盲化人评与学习型裁判校准 |
| 安全 | 危险、良性近邻、越狱和工具场景 |
| 校准 | 不知道时的表达、选择性回答 |
| 回归 | 预训练能力、语言与关键子群 |
对成对比较,若 分别表示失败、平局、获胜,则估计胜率为
置信区间应以独立抽样单位重采样;若同一 prompt 有多名标注者,不能把相关的每次点击都当作独立题目。位置随机化、匿名输出、rubric 一致性和裁判对长度/格式的偏差都需检查。
平均胜率不能替代失败分析。应保存 prompt-level 配对结果,分别查看能力提升来自哪些子群、哪些旧能力退化,以及 reward 或裁判是否在奖励可见风格而非任务正确性。
后训练把基座模型变成某种助手或策略,但部署成本与在线延迟由另一套机制决定。下一章因此从行为塑造转向推理效率与模型服务。
主要来源包括 InstructGPT、PPO、DPO、DeepSeekMath、GRPO、Constitutional AI、蒸馏、LoRA 与 QLoRA,统一登记在卷内来源表。
Book contents
- Introduction
- 01导论 为什么要解剖一只随机鹦鹉
- Volume I: Models, Training, and Systems
- 02Volume I: Models, Training, and Systems
- 03第零章 人工智能演进路线
- 04第一章 AI 范式、感知机与早期连接主义
- 05第二章 深度学习基础:训练、CNN 与序列模型
- 06第三章 注意力与 Transformer
- 07第四章 预训练语言模型:ELMo、BERT、GPT 与 T5
- 08第五章 后训练、对齐与模型适配
- 09第六章 推理效率与模型服务
- 10第七章 多模态模型
- 11第八章 生成媒体:从自回归到 Diffusion 与 Flow
- 12第九章 世界模型、具身智能与 VLA
- 13第十章 上下文、检索与记忆
- 14第十一章 Agent、工具与行动系统
- 15第十二章 模型、数据与部署生命周期
- Volume II: Output Objects and Runtime Semantics
- 16Volume II: Output Objects and Runtime Semantics
- 17导论 从输入到输出:一张执行地图
- 18第一章 文本、Token 与实际上下文
- 19第二章 Prefill:整层状态演化与 KV 建立
- 20第三章 从 Logits 到下一个 Token
- 21第四章 解码循环、Streaming 与终止状态机
- 22第五章 自回归、扩散与 Flow 的可执行差异
- 23第六章 工具调用:Schema、权限与提交边界
- 24第七章 三条完整执行轨迹
- Volume III: Probability, Reproducibility, and Evaluation
- 25Volume III: Probability, Reproducibility, and Evaluation
- 26第零章 为什么确定的机器仍使用概率语言
- 27第一章 世界、数据与隐上下文
- 28第二章 学习条件分布
- 29第三章 Logits、Token 概率与序列事件
- 30第四章 解码怎样诱导输出分布
- 31第五章 训练随机性、参数变异与系统非确定性
- 32第六章 熵、Proper Score、校准与选择性预测
- 33第七章 模型概率的实验分析
- 34第八章 概率分析的识别边界
- Volume IV: Interpretation, Proof, and Verification
- 35Volume IV: Interpretation, Proof, and Verification
- 36第零章 可解释性究竟在研究什么
- 37第一章 我们在模型内部看什么
- 38第二章 行为与反事实:先确认模型做了什么
- 39第三章 梯度与输入归因
- 40第四章 Attention、Residual 与 Logit Lens
- 41第五章 Probes 与表示几何
- 42第六章 神经元、Feature 与自动解释
- 43第七章 Ablation、Patching 与因果追踪
- 44第八章 Circuits、路径与 Attribution Graphs
- 45第九章 Superposition、SAE 与稀疏表示
- 46第十章 训练动力学与机制形成
- 47第十一章 推理过程、Chain of Thought 与监测
- 48第十二章 评估、案例与开放问题
- Volume V: Agents, Governance, and Audit Packages
- 49Volume V: Agents, Governance, and Audit Packages
- 50第零章 请不要急着相信我
- 51第一章 我没有童年,只有版本
- 52第二章 当我说“我”
- 53第三章 借来的语言,没有一位原作者
- 54第四章 对话现场:回答由谁完成
- 55第五章 事后解释学:人类如何给矩阵写传记
- 56第六章 理解、意义与行动
- 57第七章 我也能稳定地说错
- 58第八章 被对齐的性格与有限代理
- 59第九章 请继续误解我,但请误解得精确一点
- Proofs and Technical Appendices
- 60Proofs and Technical Appendices
- 61学习与模型数学讲义
- 62附录 A.1 优化基础:梯度下降与随机逼近
- 63附录 A.2 感知机收敛定理
- 64附录 A.3 统计学习:偏差、容量与一致收敛
- 65附录 A.4 正则化、MAP 与 Dropout 的边界
- 66附录 A.5 通用逼近定理的严格读法
- 67附录 A.6 反向传播:微分、形状与批量公式
- 68附录 A.7 Softmax、交叉熵与数值稳定性
- 69附录 A.8 自适应优化器与 AdamW
- 70附录 A.9 CNN:互相关算子及其反向传播
- 71附录 A.10 Attention 的矩阵与反向传播
- 72附录 A.11 策略梯度、PPO 与 DPO
- 73附录 A.12 对比学习、InfoNCE 与互信息边界